
이미지 텍스트 추출
사진, 스크린샷과 스캔한 PDF의 글자를 읽습니다. 인식 언어를 선택하고 결과를 확인한 뒤 텍스트를 복사하거나 TXT로 저장하세요.
이 도구가 하는 일
인쇄된 글자를 잘 읽습니다
인식 정확도는 선명도, 언어, 배치와 조명에 따라 달라집니다. 이름, 날짜, 숫자는 원본과 꼭 대조하세요.
아홉 가지 언어
영어, 중국어(간체·번체), 일본어, 한국어, 독일어, 프랑스어, 스페인어, 이탈리아어. 영어가 아닌 언어를 고르면 영어도 함께 불러옵니다. 실제 문서에는 주문번호, 이메일, 금액처럼 로마자로 적힌 것이 가득하기 때문입니다.
스캔 PDF를 쪽 단위로
PDF를 열어 한 쪽씩 읽으므로, 여러 쪽짜리 스캔본을 미리 이미지로 내보낼 필요가 없습니다.
여러 파일을 한 번에
폴더 하나 분량의 스크린샷을 놓으면 차례로 처리됩니다. 하나가 실패해도 나머지는 계속되므로, 잘못된 파일 하나가 전체를 멈추지 않습니다.
복사하거나 내려받기
결과를 바로 클립보드에 복사하거나.txt 파일로 저장할 수 있습니다. 파일이 여러 개면 각각 이름이 붙어 결과가 섞이지 않습니다.
이미지에서 텍스트를 추출하는 방법
파일 추가
이미지나 PDF를 끌어다 놓거나 클릭해서 고르세요. JPG, PNG, WebP, GIF, BMP, PDF를 지원하며 파일당 50MB까지입니다.
언어 선택
이 페이지의 언어가 아니라 이미지 속 글자의 언어를 고르세요. 정확도에 가장 크게 영향을 주는 것이 이 설정입니다.
텍스트 복사 또는 내려받기
파일마다 끝나는 대로 결과가 나타납니다. 전체를 클립보드에 복사하거나.txt로 저장하세요.
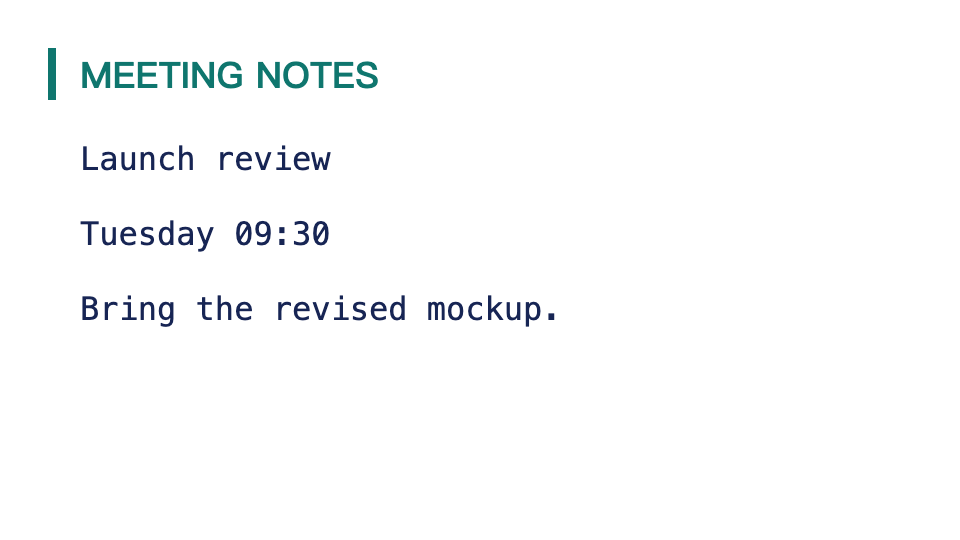
이미지 텍스트 추출 · 예시 1
이 도구 또는 도구와 동일한 처리 코드로 만든 결과입니다. 입력 파일, 설정, 결과를 비교하고 파일을 내려받아 확인하세요.
더 잘 읽히게 하려면
언어부터 제대로 고르기
영향이 가장 큰 항목입니다. 영어 모델로 한국어를 읽히면 이미지가 아무리 선명해도 알아볼 수 없는 결과만 나옵니다.
글자 부분만 잘라내기
책장을 찍으면 책상이나 손, 방의 일부까지 함께 담기기 마련입니다. 종이 면만 남기면 엔진이 헷갈릴 요소가 줄어듭니다.
밝기보다 고른 조명
종이 절반에 그림자가 드리운 편이 전체적으로 조금 어두운 것보다 훨씬 나쁩니다. 더 밝게 비추기보다 빛이 고르게 드는 자리로 옮기세요.
글줄을 수평으로
비스듬히 흐르는 글자는 눈에 띄게 잘 읽히지 않습니다. 올리기 전에 사진을 반듯하게 돌리는 몇 초는 충분히 값어치를 합니다.
원본 파일 쓰기
스크린샷의 스크린샷이나 여러 앱을 거쳐 전달된 사진은 그때마다 압축됩니다. 원본이 언제나 더 선명합니다.
인쇄체는 되고 손글씨는 안 됩니다
인쇄되거나 컴퓨터로 조판된 글자를 대상으로 합니다. 손글씨 인식은 전혀 다른 문제이며, 여기서 시도하면 실망하게 됩니다.
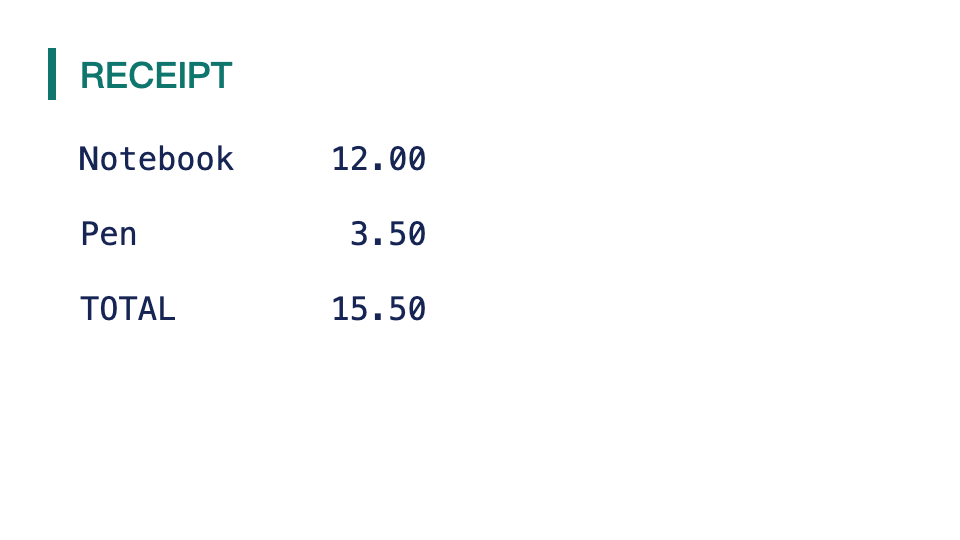
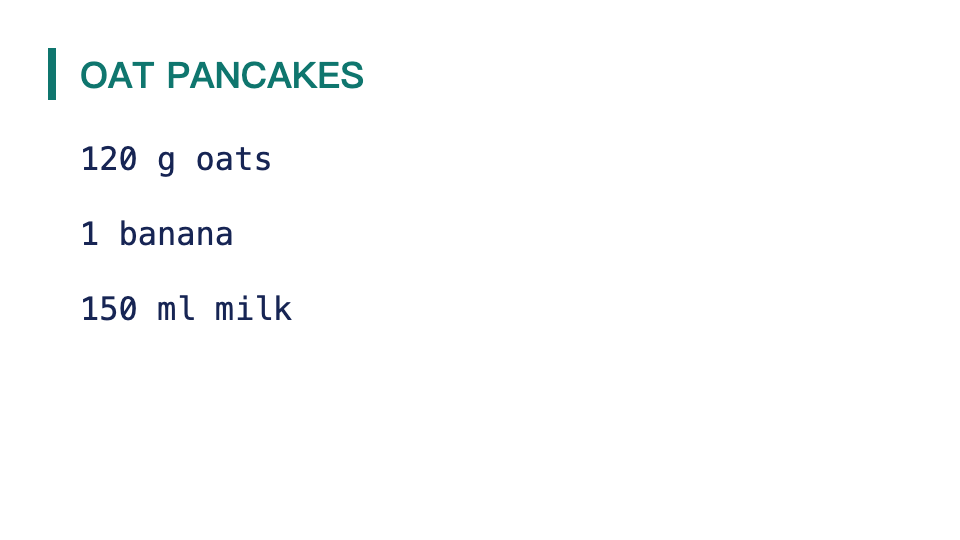
이미지 텍스트 추출 · 더 많은 예시
이 도구 또는 도구와 동일한 처리 코드로 만든 결과입니다. 입력 파일, 설정, 결과를 비교하고 파일을 내려받아 확인하세요.
텍스트 추출에 관한 질문
관련 도구
QR 코드 디코더
무료 온라인 QR 코드 디코더·스캐너. QR 코드 이미지를 업로드해 URL, 텍스트, WiFi 인증 정보를 추출하세요. 브라우저에서 안전하게 처리됩니다.
PDF → JPG
PDF 페이지를 JPG 이미지로 변환합니다. 배율과 품질을 정하고 페이지별 이미지 또는 하나의 긴 이미지로 저장하세요.
이미지 정보 뷰어
이미지의 픽셀 크기, 형식, 파일 용량과 읽을 수 있는 EXIF 정보를 확인합니다. 지정한 DPI로 인쇄 크기를 환산할 수 있습니다.
이미지를 아스키 아트로 변환
사진을 ASCII 문자로 표현합니다. 출력 너비, 문자 집합과 색상을 조절한 뒤 텍스트를 복사하거나 TXT와 PNG로 저장하세요.