
画像から文字を抽出
スクリーンショット・写真・スキャンしたPDFから文字を抽出します。認識はブラウザ内で行われ、画像はアップロードされません。複数ファイルの一括処理に対応。
このツールでできること
活字はよく読めます
認識精度は画像の鮮明さ、言語、レイアウト、照明によって変わります。特に名前・日付・数字は原本と照合してください。
9 言語に対応
英語、中国語(簡体字・繁体字)、日本語、韓国語、ドイツ語、フランス語、スペイン語、イタリア語。英語以外を選ぶと英語も一緒に読み込みます。実際の書類は注文番号やメールアドレスなど、ラテン文字だらけだからです。
スキャン PDF をページごとに
PDF を開いて 1 ページずつ読み取るので、複数ページのスキャンでも、あらかじめ画像に書き出しておく必要はありません。
複数ファイルをまとめて
フォルダ一式のスクリーンショットをドロップすれば順番に処理されます。1 つが失敗しても残りは続くので、1 件の不良ファイルで全体が止まることはありません。
コピーまたはダウンロード
結果はそのままクリップボードへコピーできますし、.txt ファイルとして保存もできます。複数ファイルの場合はファイル名が付くので、結果が混ざりません。
画像から文字を抽出する手順
ファイルを追加
画像や PDF をドラッグするか、クリックして選択します。JPG・PNG・WebP・GIF・BMP・PDF に対応、1 ファイル 50MB までです。
言語を選ぶ
このページの言語ではなく、画像の中の文字の言語を選んでください。精度に最も影響するのがこの設定です。
テキストをコピー/ダウンロード
ファイルごとに終わり次第、結果が表示されます。まとめてコピーするか、.txt として保存してください。
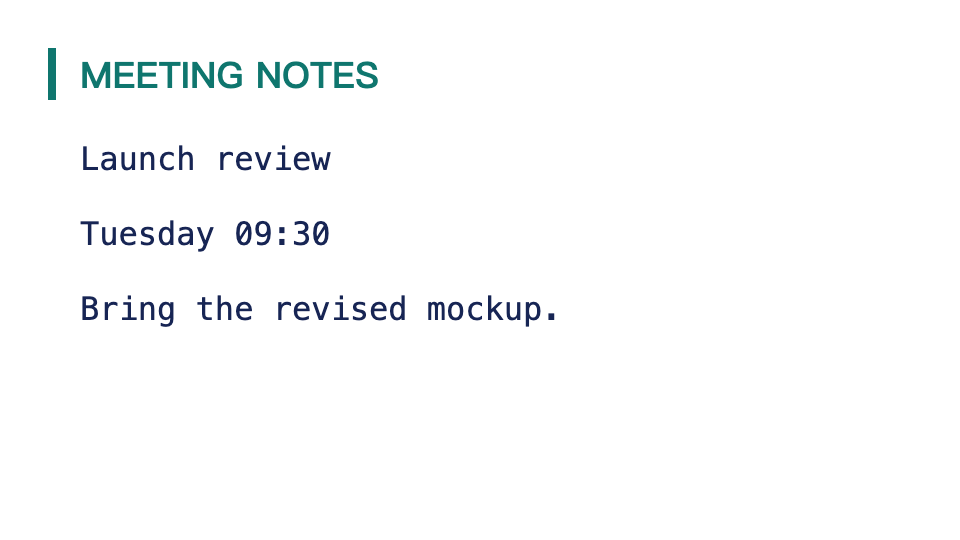
画像から文字を抽出 · 処理例 1
このツール、またはツールと共通の処理コードで作成した結果です。入力、設定、出力を比較し、ファイルをダウンロードして確認できます。
精度を上げるコツ
まず言語を正しく選ぶ
影響が最も大きいのがこれです。英語のモデルで日本語を読ませれば、どれだけ鮮明な画像でも意味不明な文字列にしかなりません。
文字の部分だけに切り抜く
ページを撮ると机や手、部屋の一部まで写り込みがちです。紙面だけに切り抜けば、エンジンが迷う要素が減ります。
明るさより「ムラのなさ」
紙の半分に影が落ちているほうが、全体的に少し暗いことより悪影響です。強い光を当てるより、光が均一になる位置へ移動してください。
文字を水平に保つ
斜めに走る文字は明らかに読み取りにくくなります。アップロード前に写真をまっすぐにする数秒は、十分に見合います。
スクリーンショットより元ファイル
スクリーンショットのスクリーンショットや、複数のアプリを経由して転送された写真は、そのたびに圧縮されています。元のファイルのほうが常に鮮明です。
活字は可、手書きは不可
対象は活字と、パソコンで組まれた文字です。手書きの認識はまったく別の問題で、ここで試しても期待には応えられません。
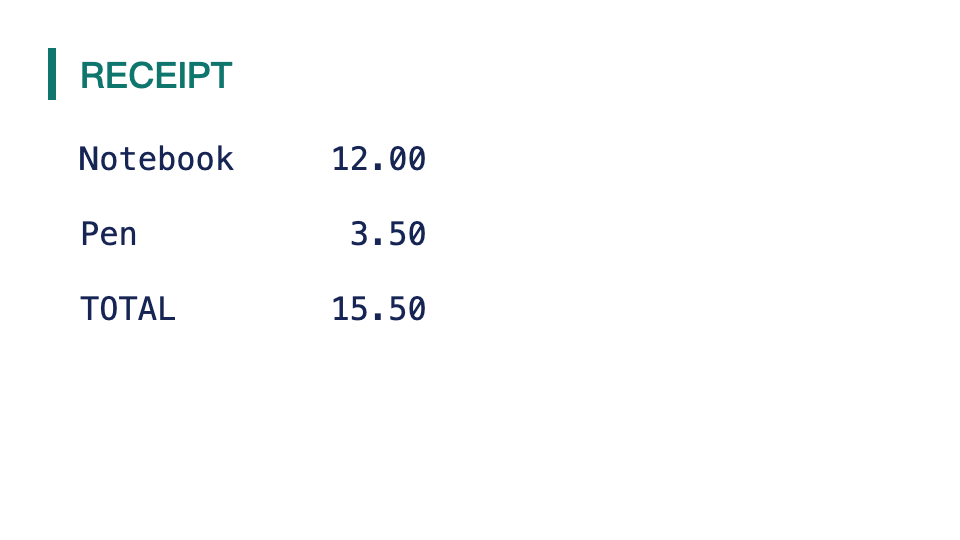
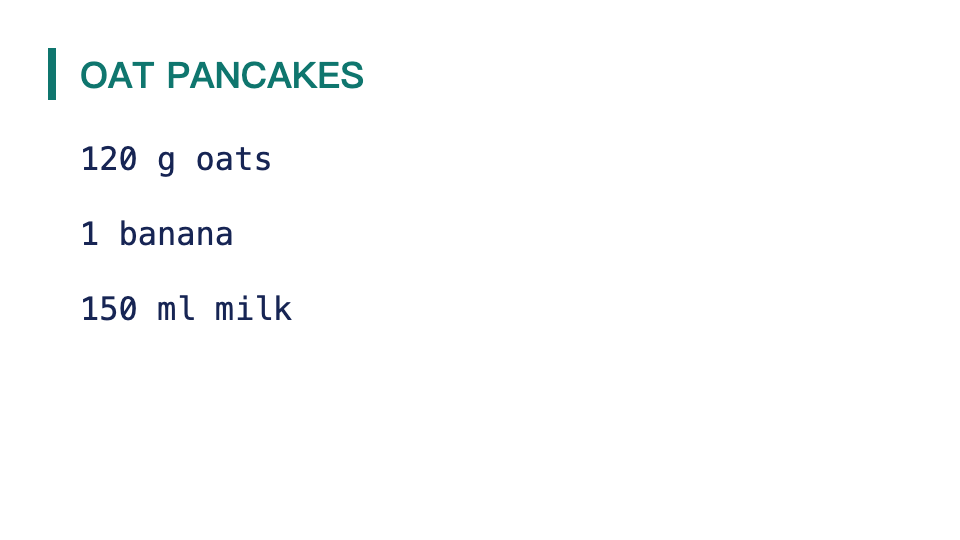
画像から文字を抽出 · その他の処理例
このツール、またはツールと共通の処理コードで作成した結果です。入力、設定、出力を比較し、ファイルをダウンロードして確認できます。
画像の文字抽出についてのご質問
関連ツール
QRコードデコーダー
QR コードをオンラインでデコードできる無料の QR コードスキャナー&リーダー。QR コード画像をアップロードして URL・テキスト・WiFi 認証情報などを抽出。
PDF を JPG に変換
PDF のページを JPG 画像に変換します。倍率と品質を設定し、ページごと、または縦長の一枚画像として保存できます。
画像情報ビューア
画像のピクセル寸法、形式、容量、読み取れる EXIF 情報を確認します。指定した DPI から印刷時の寸法も計算できます。
画像をアスキーアートに変換
画像を無料でアスキーアートに変換。出力幅の調整、複数の文字セット、反転・カラーモードに対応し、テキストコピーや TXT/PNG 保存も可能。登録不要・アップロード不要。