
Extraire le texte d'une image et d'un PDF
Récupérez le texte de vos captures d'écran, photos et PDF scannés. La reconnaissance a lieu dans votre navigateur, rien n'est envoyé en ligne. Plusieurs fichiers à la fois.
Ce que fait cet outil
Le texte imprimé est bien reconnu
La précision dépend de la netteté, de la langue, de la mise en page et de l’éclairage. Comparez le texte à l’original, surtout les noms, dates et nombres.
Neuf langues
Anglais, chinois (simplifié et traditionnel), japonais, coréen, allemand, français, espagnol et italien. Les langues autres que l'anglais chargent aussi l'anglais, car les vrais documents regorgent de numéros de commande, d'adresses e-mail et de montants en caractères latins.
PDF scannés, page par page
Le PDF est ouvert et chaque page lue à son tour : vous n'avez pas à exporter les pages en images au préalable.
Plusieurs fichiers à la fois
Déposez un dossier entier de captures, elles se mettent en file. Si l'une échoue, les autres continuent — un fichier défectueux n'arrête pas le lot.
Copier ou télécharger
Envoyez le résultat directement dans le presse-papiers, ou téléchargez-le en.txt. Avec plusieurs fichiers, chaque résultat est identifié pour ne rien mélanger.
Comment extraire le texte d'une image
Ajoutez vos fichiers
Glissez des images ou un PDF, ou cliquez pour parcourir. JPG, PNG, WebP, GIF, BMP et PDF fonctionnent, jusqu'à 50 Mo par fichier.
Choisissez la langue
Celle du texte dans l'image, pas celle de cette page. C'est le réglage qui pèse le plus sur la précision.
Copiez ou téléchargez le texte
Les résultats apparaissent au fur et à mesure. Copiez l'ensemble dans le presse-papiers ou enregistrez-le en.txt.
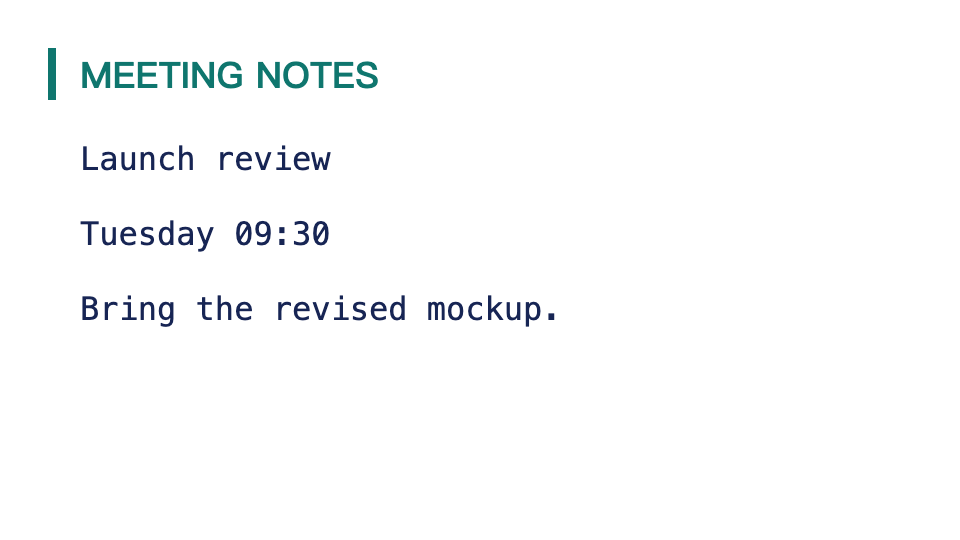
Extraire le texte d'une image et d'un PDF · Exemple 1
Ces fichiers ont été traités avec cet outil ou le même code de traitement. Comparez les sources, les réglages et les résultats à télécharger.
Pour de meilleurs résultats
Réglez d'abord la langue
C'est de loin le facteur le plus important. Lire du chinois avec le modèle anglais donnera n'importe quoi, aussi nette soit l'image.
Recadrez sur le texte
Les photos de pages incluent souvent le bureau, une main, un bout de la pièce. En ne gardant que le papier, la reconnaissance a moins de quoi se troubler.
Un éclairage régulier vaut mieux qu'un éclairage fort
Une ombre en travers de la page nuit davantage qu'une photo un peu sombre dans l'ensemble. Déplacez-vous pour que la lumière soit régulière plutôt que puissante.
Gardez les lignes horizontales
Un texte de biais est nettement moins bien lu. Redresser la photo avant de l'envoyer vaut largement les quelques secondes.
Utilisez le fichier d'origine
Une capture de capture, ou une photo passée par plusieurs messageries, a été recompressée à chaque fois. L'original est toujours plus net.
Texte imprimé oui, écriture manuscrite non
L'outil vise le texte imprimé et composé. L'écriture manuscrite est un tout autre problème et le résultat vous décevra.
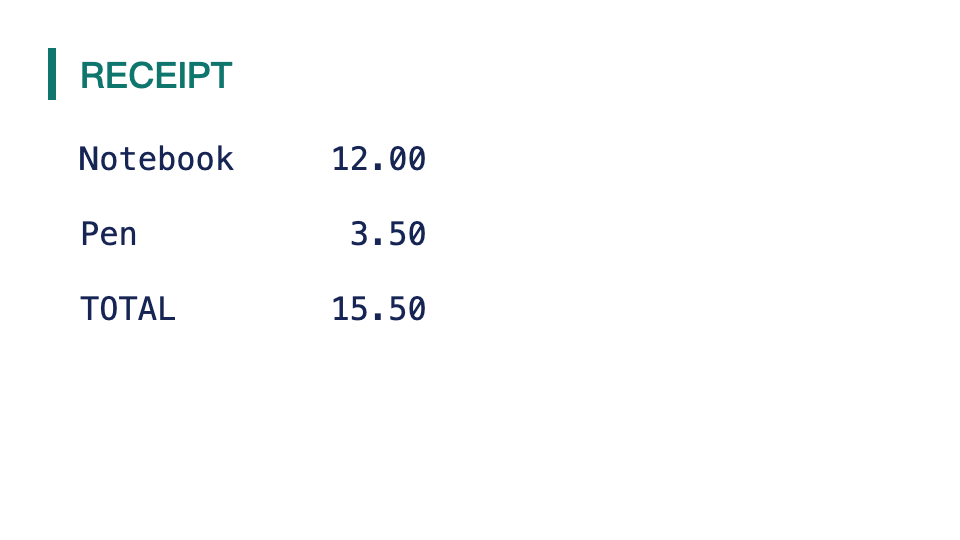
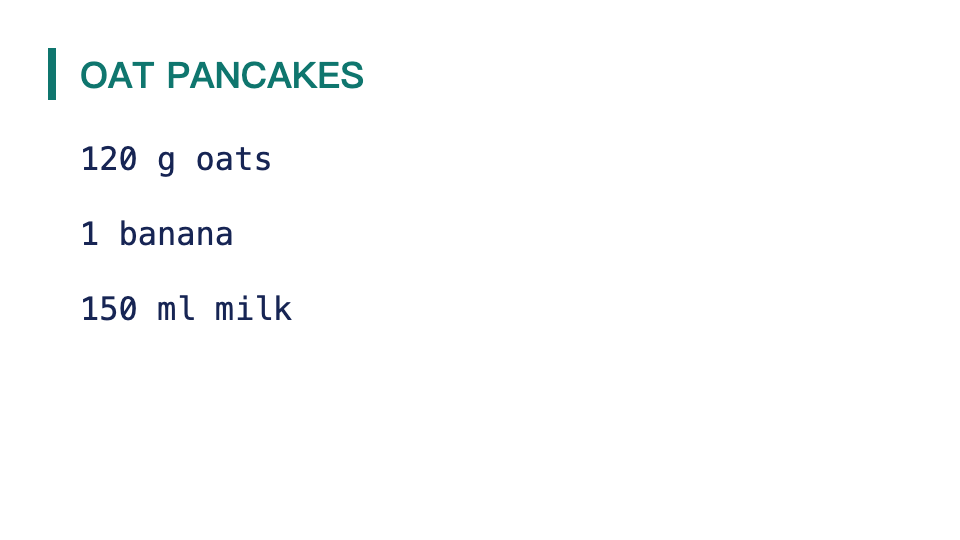
Extraire le texte d'une image et d'un PDF · Autres exemples
Ces fichiers ont été traités avec cet outil ou le même code de traitement. Comparez les sources, les réglages et les résultats à télécharger.
Questions sur l'extraction de texte
Outils associés
Décodeur de QR Code
Décodez les QR codes en ligne. Scanner et lecteur gratuit : importez une image de QR code pour extraire URL, texte ou WiFi.
PDF en JPG
Choisissez un PDF, le mode de pages et l’échelle. Pour JPG, vous pouvez aussi régler la qualité de sortie.
Visualiseur d'Info Image
Consultez les dimensions en pixels, le format, le poids et les données EXIF lisibles. Calculez les dimensions d’impression à partir du DPI choisi.
Image en Art ASCII
Convertissez vos images en art ASCII gratuitement. Largeur réglable, jeux de caractères, modes inversé et couleur, export TXT/PNG.