
Estrarre testo da immagine e PDF
Recupera il testo da screenshot, foto e PDF scansionati. Il riconoscimento avviene nel browser, non viene caricato nulla. Più file alla volta.
Cosa fa questo strumento
Legge bene il testo stampato
La precisione dipende da nitidezza, lingua, impaginazione e luce. Confronta il testo estratto con l’originale, soprattutto nomi, date e numeri.
Nove lingue
Inglese, cinese (semplificato e tradizionale), giapponese, coreano, tedesco, francese, spagnolo e italiano. Le lingue diverse dall'inglese caricano anche l'inglese, perché i documenti reali sono pieni di numeri d'ordine, indirizzi e-mail e importi in caratteri latini.
PDF scansionati, pagina per pagina
Il PDF viene aperto e ogni pagina letta a turno, così non devi esportare prima le pagine come immagini.
Più file alla volta
Trascina un'intera cartella di screenshot e si mettono in coda. Se uno fallisce gli altri proseguono — un file difettoso non blocca l'intero gruppo.
Copia o scarica
Porta il risultato direttamente negli appunti, oppure scaricalo come file.txt. Con più file ogni risultato è etichettato, così non si confondono.
Come estrarre il testo da un'immagine
Aggiungi i file
Trascina immagini o un PDF, oppure clicca per sceglierli. Vanno bene JPG, PNG, WebP, GIF, BMP e PDF, fino a 50 MB ciascuno.
Scegli la lingua
Quella del testo nell'immagine, non quella di questa pagina. Per la precisione questa impostazione conta più di ogni altra cosa.
Copia o scarica il testo
I risultati compaiono man mano che i file finiscono. Copia tutto negli appunti o salvalo come.txt.
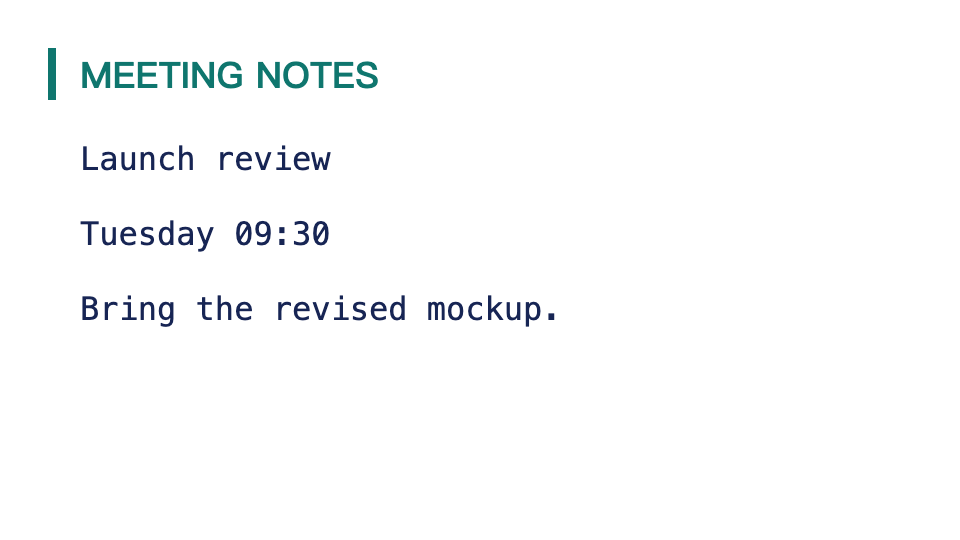
Estrarre testo da immagine e PDF · Esempio 1
Questi file sono stati elaborati con questo strumento o con lo stesso codice. Confronta gli originali, le impostazioni e i risultati scaricabili.
Per risultati migliori
Imposta prima la lingua
È di gran lunga il fattore più importante. Leggere testo cinese con il modello inglese produrrà accozzaglie, per quanto nitida sia l'immagine.
Ritaglia lasciando solo il testo
Le foto di pagine includono spesso la scrivania, una mano, un pezzo di stanza. Lasciando solo il foglio, il motore ha meno elementi che lo confondono.
Meglio luce uniforme che luce forte
Un'ombra che attraversa metà pagina danneggia più di una foto complessivamente un po' scura. Spostati perché la luce sia uniforme, invece di renderla più intensa.
Tieni le righe orizzontali
Il testo inclinato si legge sensibilmente peggio. Raddrizzare la foto prima di caricarla vale quei pochi secondi.
Usa il file originale
Uno screenshot di uno screenshot, o una foto inoltrata attraverso più app di messaggistica, è stata ricompressa ogni volta. L'originale è sempre più nitido.
Testo stampato sì, scrittura a mano no
Lo strumento è pensato per testo stampato e composto. La scrittura a mano è un problema davvero diverso e il risultato ti deluderà.
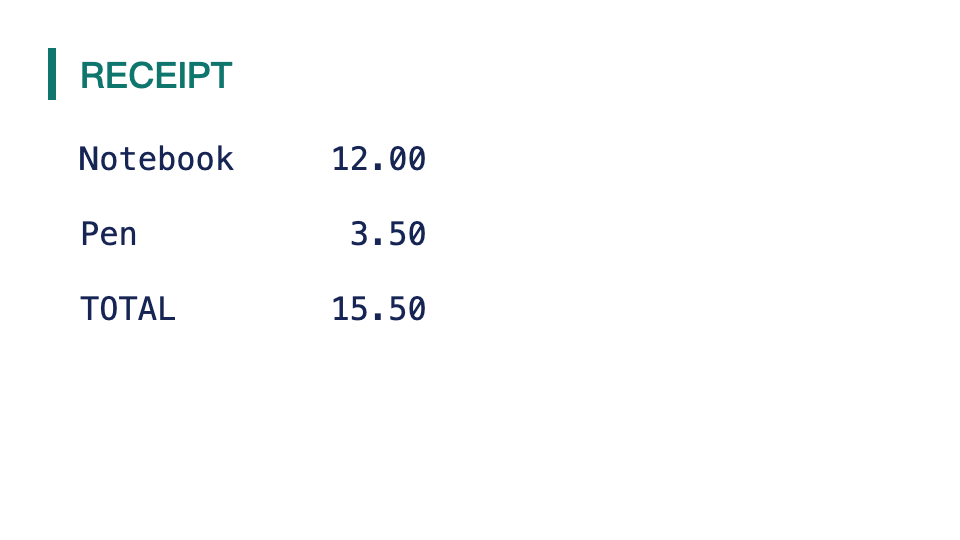
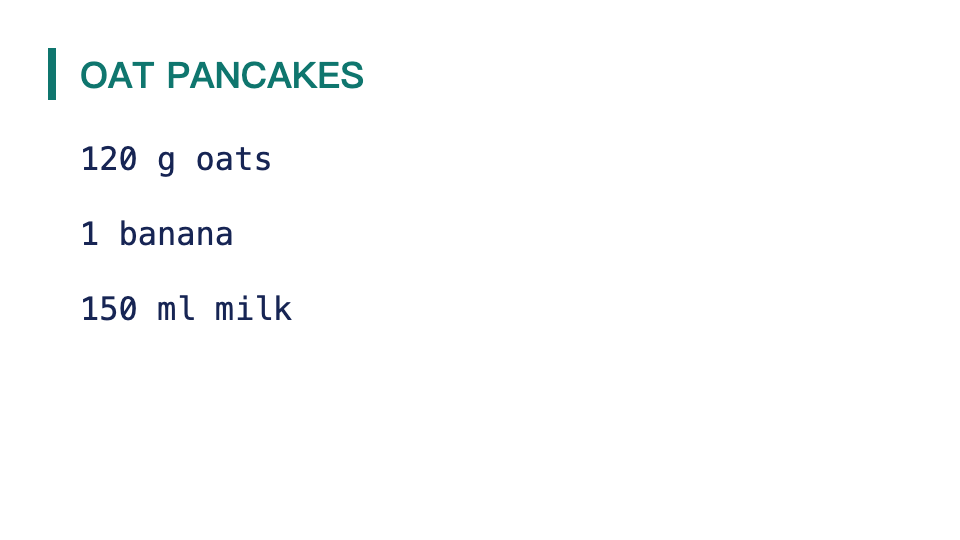
Estrarre testo da immagine e PDF · Altri esempi
Questi file sono stati elaborati con questo strumento o con lo stesso codice. Confronta gli originali, le impostazioni e i risultati scaricabili.
Domande sull'estrazione del testo
Strumenti correlati
Decodificatore QR Code
Decodifica i codici QR online. Scanner e lettore QR gratuito. Carica immagini di codici QR per estrarre URL, testo e WiFi.
PDF in JPG
Scegli un PDF, la modalità delle pagine e la scala. Per JPG puoi regolare anche la qualità di uscita.
Visualizzatore Info Immagine
Controlla dimensioni in pixel, formato, peso del file e dati EXIF leggibili. Calcola le dimensioni di stampa usando il valore DPI scelto.
Immagine in ASCII Art
Converti immagini in ASCII art online gratis. Trasforma qualsiasi foto in caratteri ASCII con larghezza regolabile e colori.