
Extraer texto de imagen y PDF
Saca el texto de capturas de pantalla, fotos y PDF escaneados. El reconocimiento ocurre en tu navegador, no se sube nada. Varios archivos a la vez.
Qué hace esta herramienta
Lee bien el texto impreso
La precisión depende de la nitidez, el idioma, el diseño y la iluminación. Revisa el texto extraído con el original, en especial nombres, fechas y cifras.
Nueve idiomas
Inglés, chino (simplificado y tradicional), japonés, coreano, alemán, francés, español e italiano. Las opciones que no son inglés cargan también el inglés, porque los documentos reales están llenos de números de pedido, correos e importes en caracteres latinos.
PDF escaneados, página a página
El PDF se abre y cada página se lee por turno, así que no tienes que exportar las páginas como imágenes antes.
Varios archivos a la vez
Suelta una carpeta entera de capturas y se ponen en cola. Si una falla, las demás siguen — un archivo defectuoso no detiene el lote.
Copiar o descargar
Lleva el resultado directamente al portapapeles o descárgalo como archivo.txt. Con varios archivos, cada resultado va etiquetado para que no se mezclen.
Cómo extraer el texto de una imagen
Añade tus archivos
Arrastra imágenes o un PDF, o haz clic para elegirlos. Funcionan JPG, PNG, WebP, GIF, BMP y PDF, hasta 50 MB cada uno.
Elige el idioma
El del texto de la imagen, no el de esta página. Este ajuste influye en la precisión más que ningún otro.
Copia o descarga el texto
Los resultados aparecen según van terminando los archivos. Copia todo al portapapeles o guárdalo como.txt.
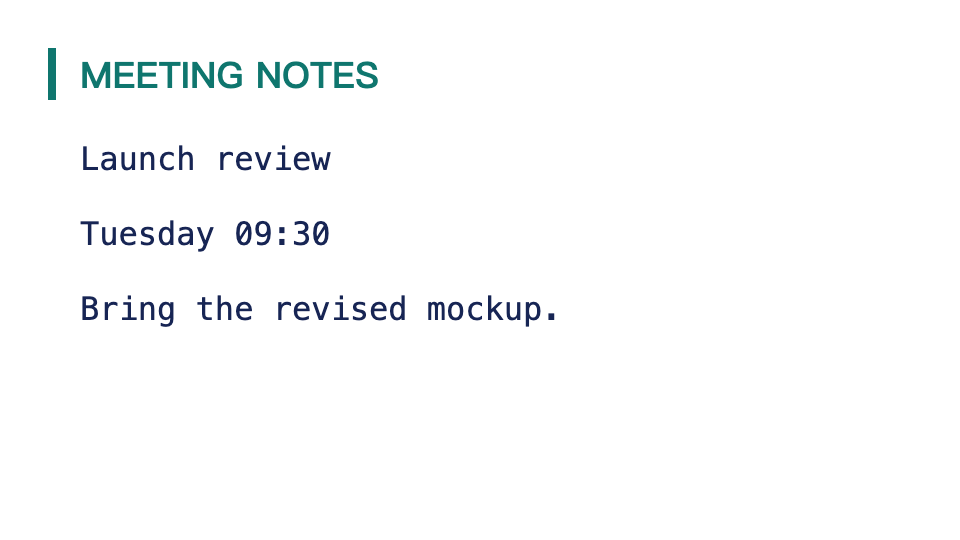
Extraer texto de imagen y PDF · Ejemplo 1
Estos archivos se han procesado con esta herramienta o con su mismo código. Compara los originales, los ajustes y los resultados descargables.
Para obtener mejores resultados
Ajusta primero el idioma
Es con diferencia el factor que más pesa. Leer texto en chino con el modelo de inglés dará un galimatías por muy nítida que sea la imagen.
Recorta hasta dejar solo el texto
Las fotos de páginas suelen incluir la mesa, una mano, parte de la habitación. Dejando solo el papel, el motor tiene menos con lo que confundirse.
Mejor luz uniforme que luz intensa
Una sombra cruzando media página perjudica más que una foto algo oscura en conjunto. Muévete para que la luz sea uniforme en lugar de más fuerte.
Mantén las líneas horizontales
El texto inclinado se lee bastante peor. Enderezar la foto antes de subirla merece esos segundos.
Usa el archivo original
Una captura de una captura, o una foto reenviada por varias aplicaciones de mensajería, se ha comprimido cada vez. El original siempre es más nítido.
Texto impreso sí, manuscrito no
Esto funciona con texto impreso y compuesto. La escritura a mano es un problema realmente distinto y el resultado te decepcionará.
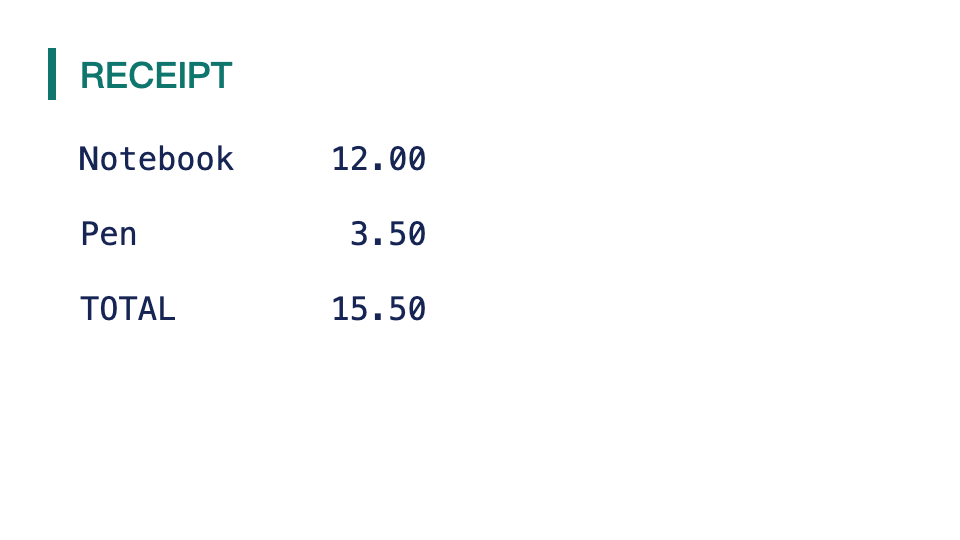
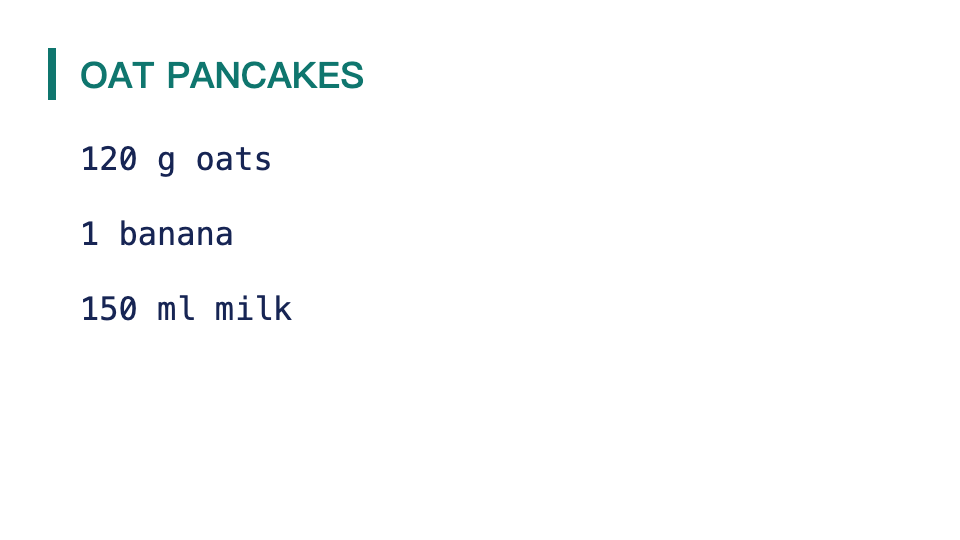
Extraer texto de imagen y PDF · Más ejemplos
Estos archivos se han procesado con esta herramienta o con su mismo código. Compara los originales, los ajustes y los resultados descargables.
Preguntas sobre extraer texto
Herramientas relacionadas
Decodificador de Códigos QR
Decodifica códigos QR online. Escáner y lector de códigos QR gratis. Sube imágenes QR para extraer URLs, texto y claves WiFi.
PDF a JPG
Elige un PDF, el modo de páginas y la escala. Para JPG también puedes ajustar la calidad de salida.
Visor de Información de Imagen
Consulta las dimensiones en píxeles, el formato, el peso y los datos EXIF disponibles. Calcula el tamaño de impresión con el valor DPI que elijas.
Imagen a Arte ASCII
Convierte imágenes a arte ASCII online gratis. Transforma cualquier foto en caracteres ASCII con ancho ajustable y modo a color.